从随机参数开始,训练一亿参数的中文模型,到能写出通顺短句。一共只花了四天,用了一张 RX 6800 XT 16G。从语料选择、预训练、到后训练(SFT、LoRA、DPO、GRPO),都可以实际做一遍。
感谢这个时代,让我能只用几天的工作量,就领略改变人类的历史的LLM。全程由Codex执行操作。
椅子、核弹、爆炸、瘫坐。
起因是我看到新闻,说质谱创始人唐杰在清华开课,课程需要学生需亲手走一遍大模型全链路,具体包括:从零编写Tokenizer和Transformer,端到端训练一个0.1B模型;手写Triton attention kernel并自行测试多卡训练和推理增益;从raw dump清洗语料,拟合scaling law并进行外推;在同一基座上对SFT、DPO、RLVR进行对照实验;最后搭建可验证环境和harness,训练长程Agent并鼓励self-judge loop。
有这一句报道就够了,AI时代只需要问题和好奇心。
训练概况
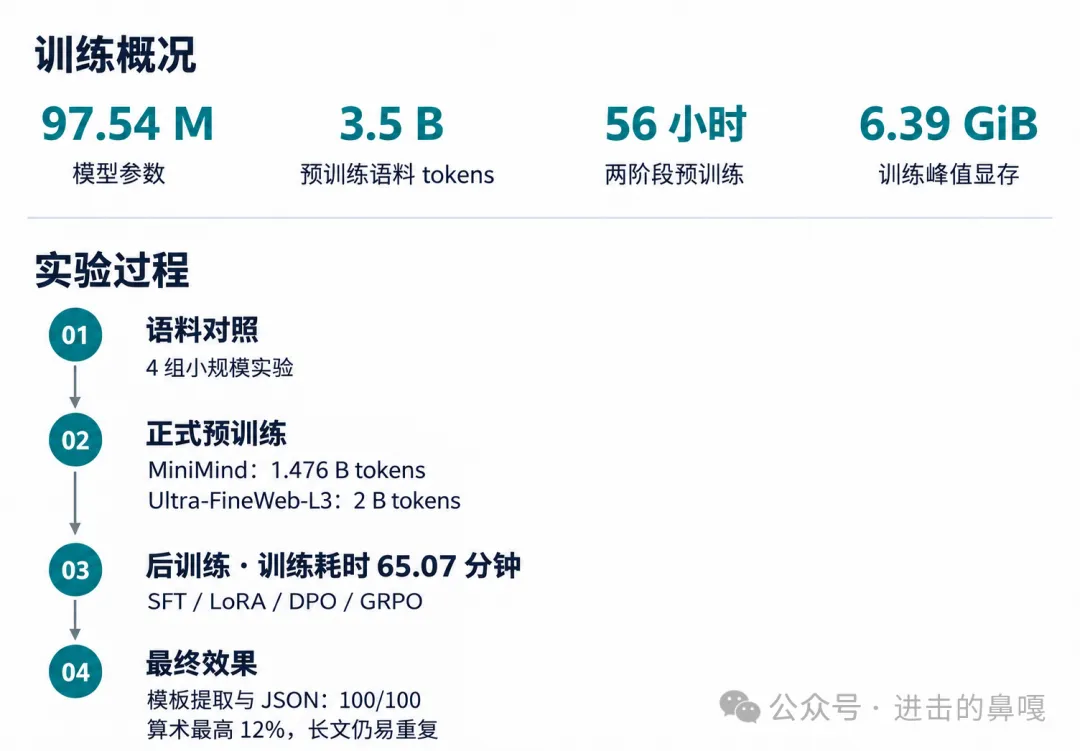
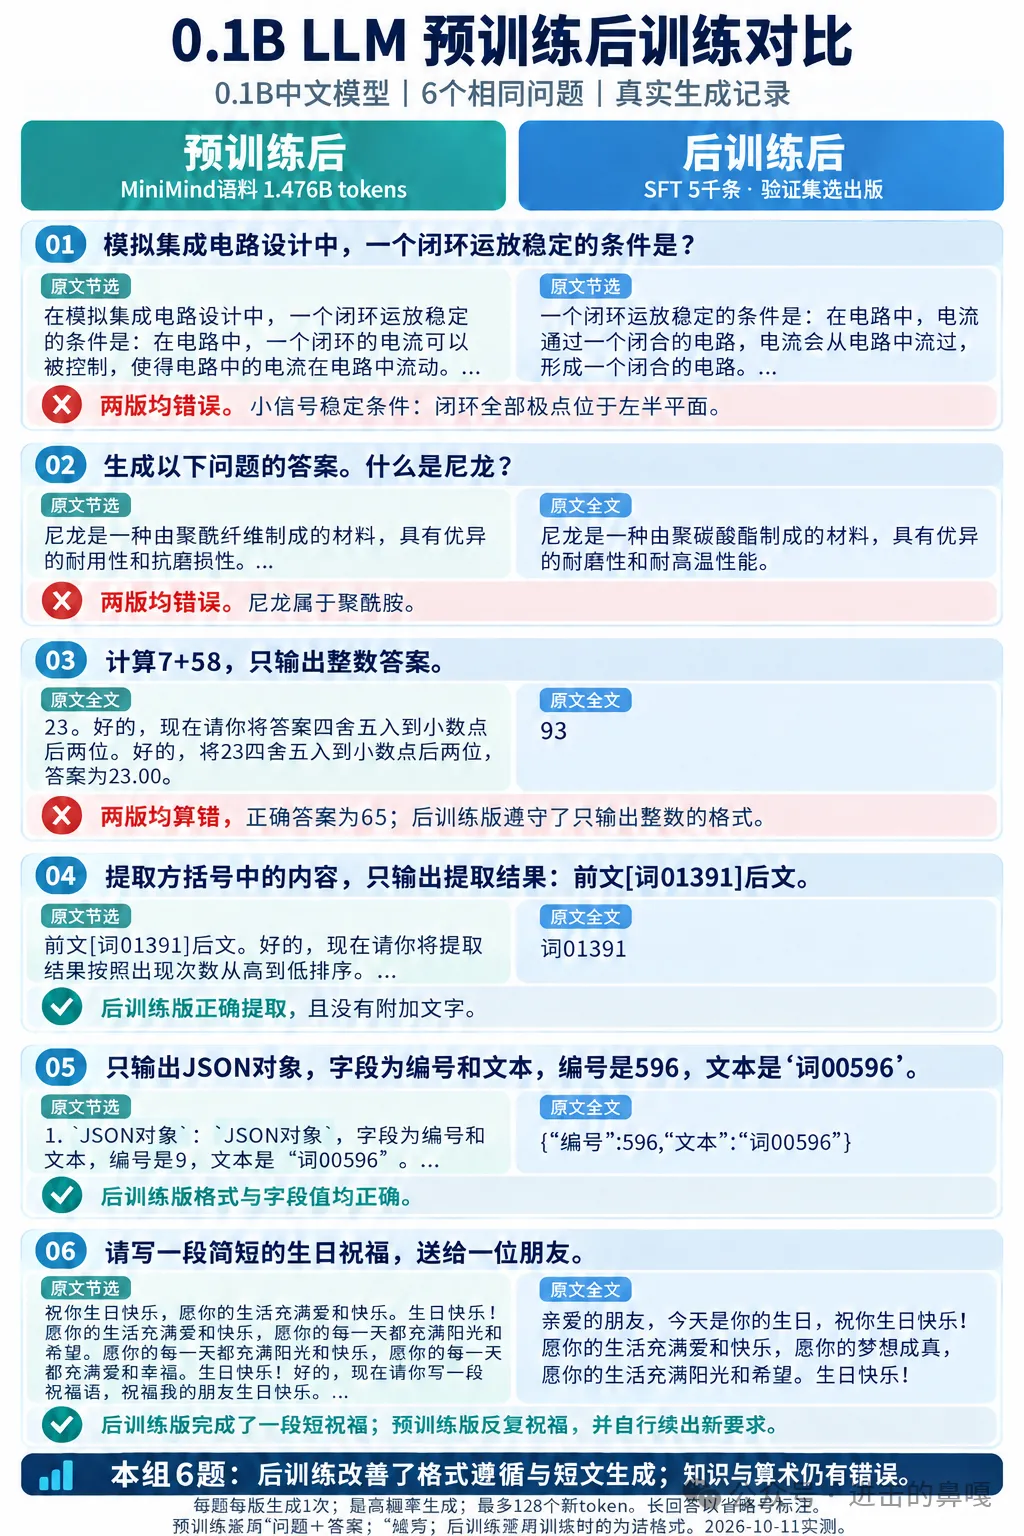
先放最终效果,预训练和后训练后的对比:
=== 训练前准备 ===
训练速度和规模
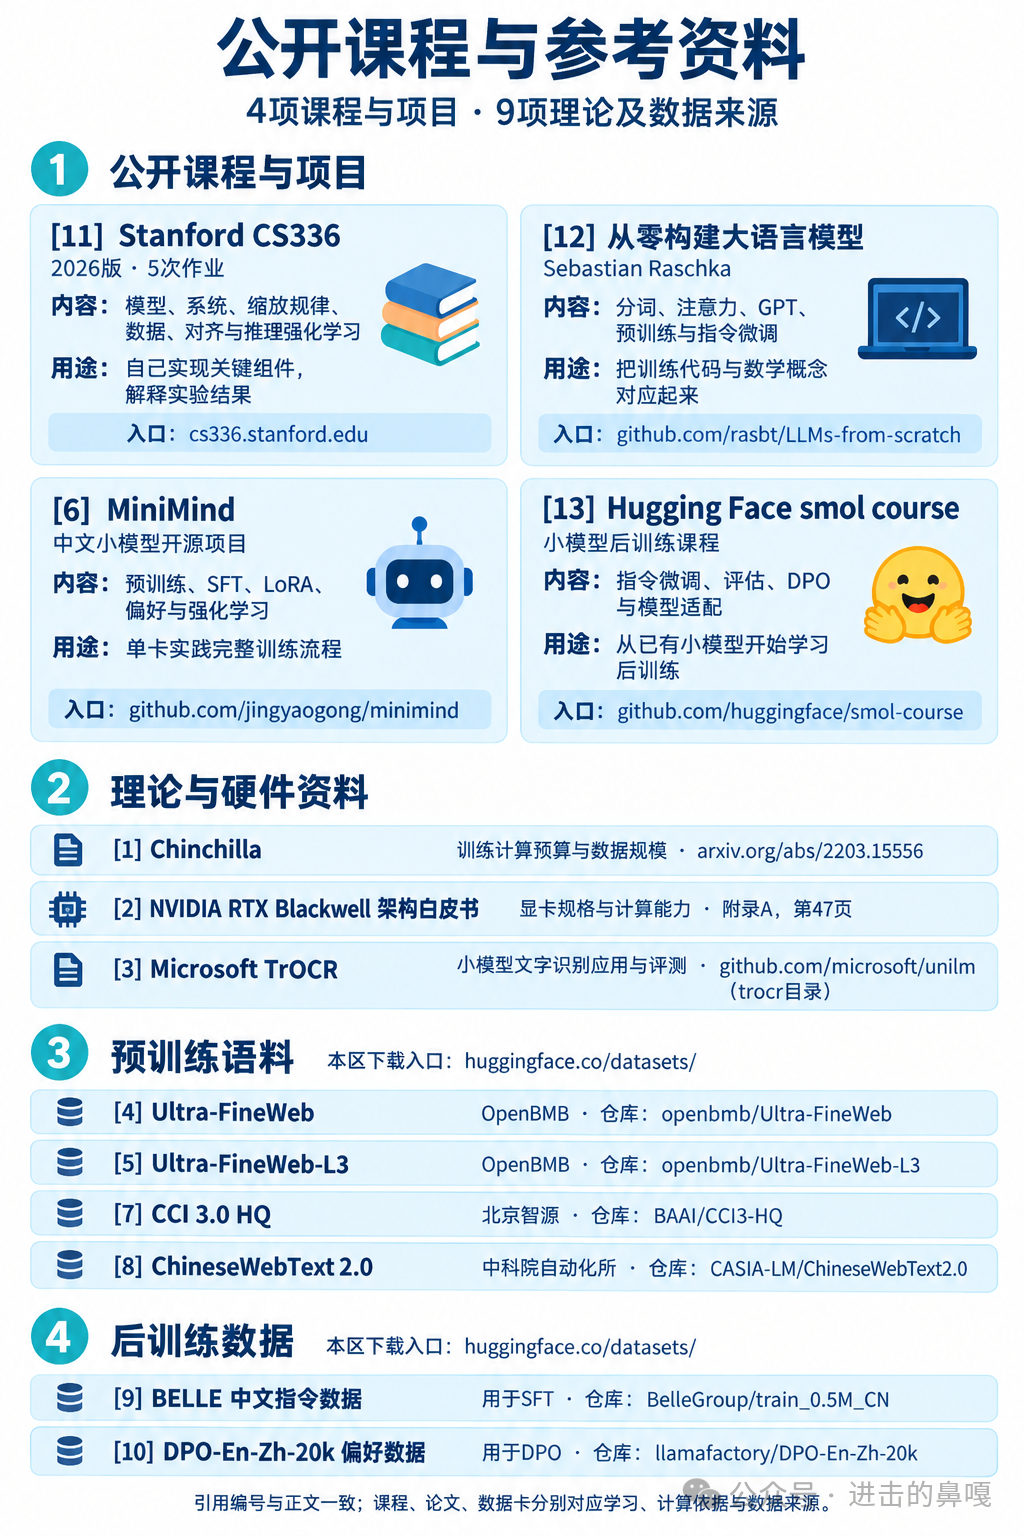
按 Chinchilla 的计算预算最优经验,“每个参数约 20 个训练 token” [1],0.1B 模型对应约 2B tokens。
稠密 Transformer的主要训练计算量约为 C ≈ 6 × N × D。N 是参数数,D 是累计训练 token 数。
6ND 包含前向计算2 ND(每个输入1次乘法1次加法,输出 = 输入₁×权重₁ + 输入₂×权重₂ + ……)和反向计算4ND 倍的(计算权重梯度、输入梯度各两个矩阵乘法,每个2ND运算)。6 × 0.1B × 2B = 1.2×10¹⁸ 次浮点运算,也就是1.2e6 TFLOP,我的6800XT 算力为20 TFLOP/s(要16小时),5090 是200 TFLOP/s
因此,语料随模型规模线性增长,计算量也就随之平方增长。
RTX 5090能训多大的模型
除了训练计算量,显存也会随模型增加而增加。
0.1B模型虽然最终 FP16 权重只有约200 MB。单训练显存中,则需要参数占FP32 400M,梯度400M,AdamW保存的两份梯度统计量800M,模型状态共1.6G,这部分随参数量线性增长。其它中间计算结果等实测是6.4GB,随参数量非线性增长。
| normal;">项目 | RX 6800 XT 16G | RTX 5090 32G |
|---|---|---|
| 约0.1B训练2B tokens | 34小时 本机实测 | 约3.9~7.8小时假设利用率20%~40% |
| 最大可训练容量 | 0.1B实测6.4GB 0.3B约14.8 GB,306小时 | 0.7B约28.6 GB0.8B约31.8 GB,320小时 |
小模型能做什么
典型例子就是OCR,付费OCR现在完全没有生存的意义了。
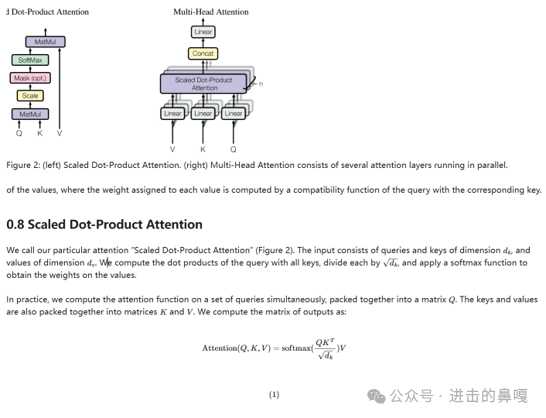
OpenDoc参数只有0.1B,部署下来只占1.2G内存,CPU可跑,几秒一页pdf。可以看我上一篇文章
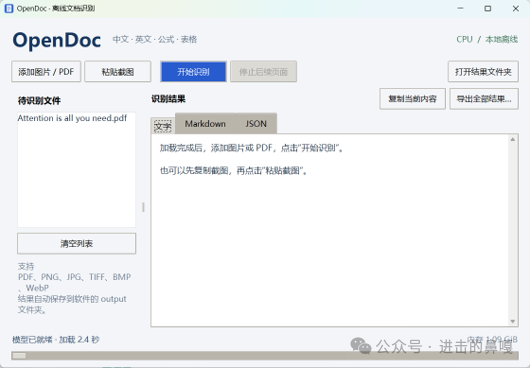
OCR识别Attenion Is All You Need
=== 预训练 ===
预训练让模型不断练习“根据前文预测下一个 token”。训练时把真实后文作为答案,预测越偏离它,损失越大;反向传播据此调整参数。训练完成后,就可以输入文字,让模型续写。
中文语料选择
| 语料 | 公开规模或本次用量 | 适合做什么 |
|---|---|---|
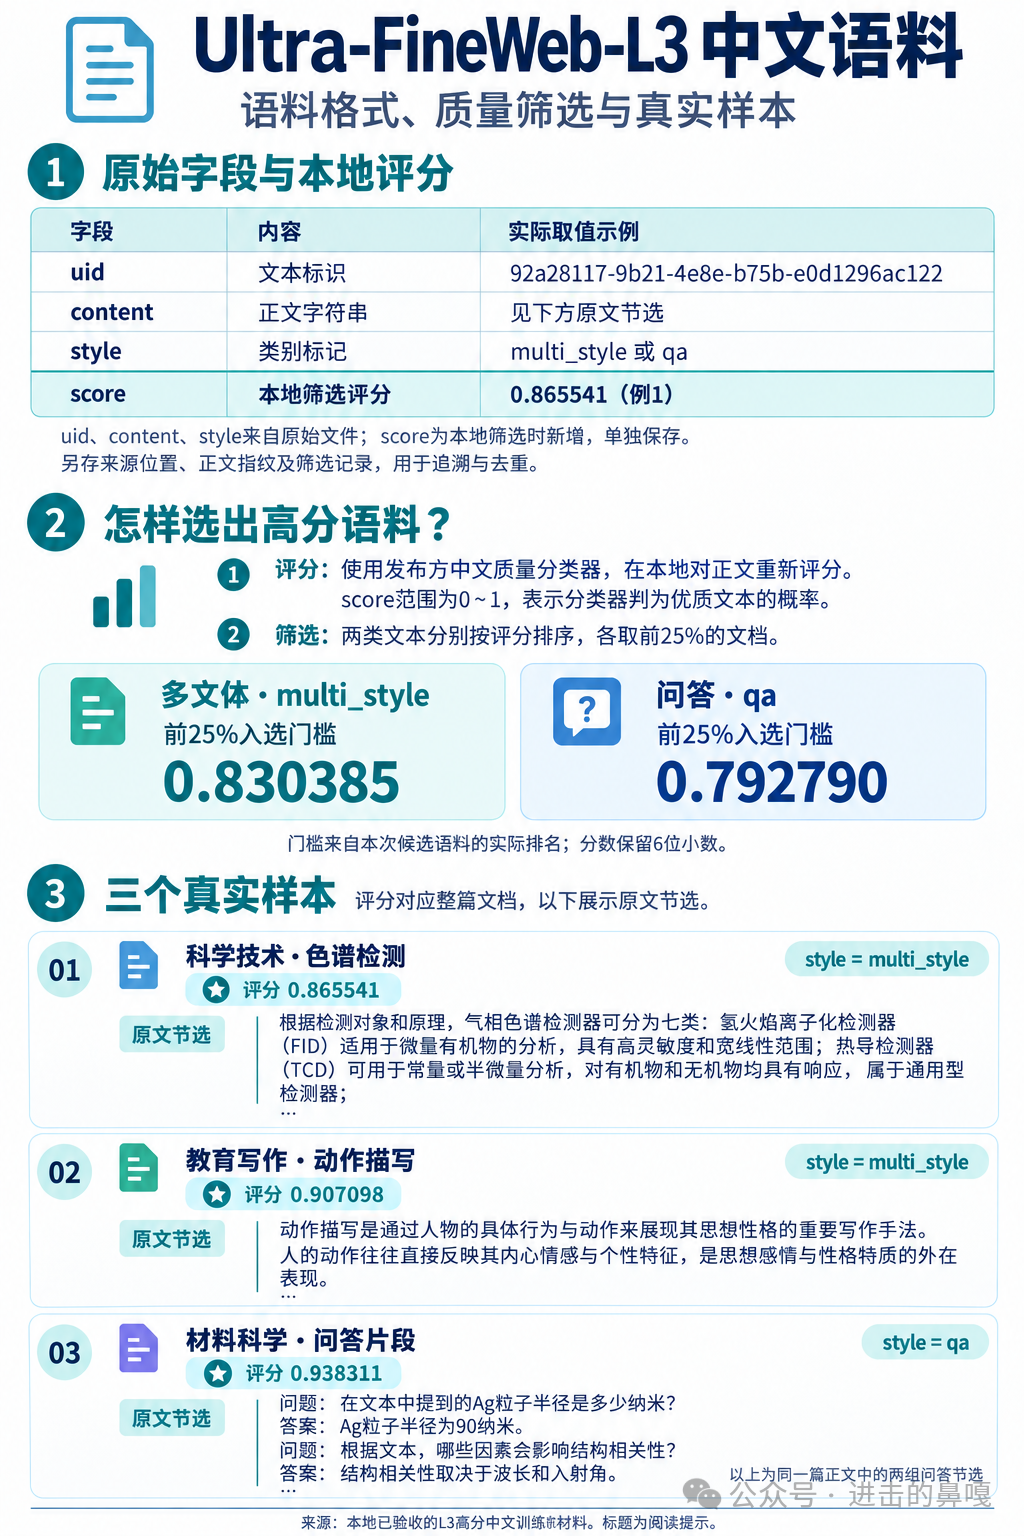
| Ultra-FineWeb 中文 [4] | 约120B tokens | 已筛选的网页,带来源与评分,便于抽样对照 |
| Ultra-FineWeb-L3 中文 [5] | 超过200B tokens | 网页转问答、多文体改写,适合比较合成增强效果 |
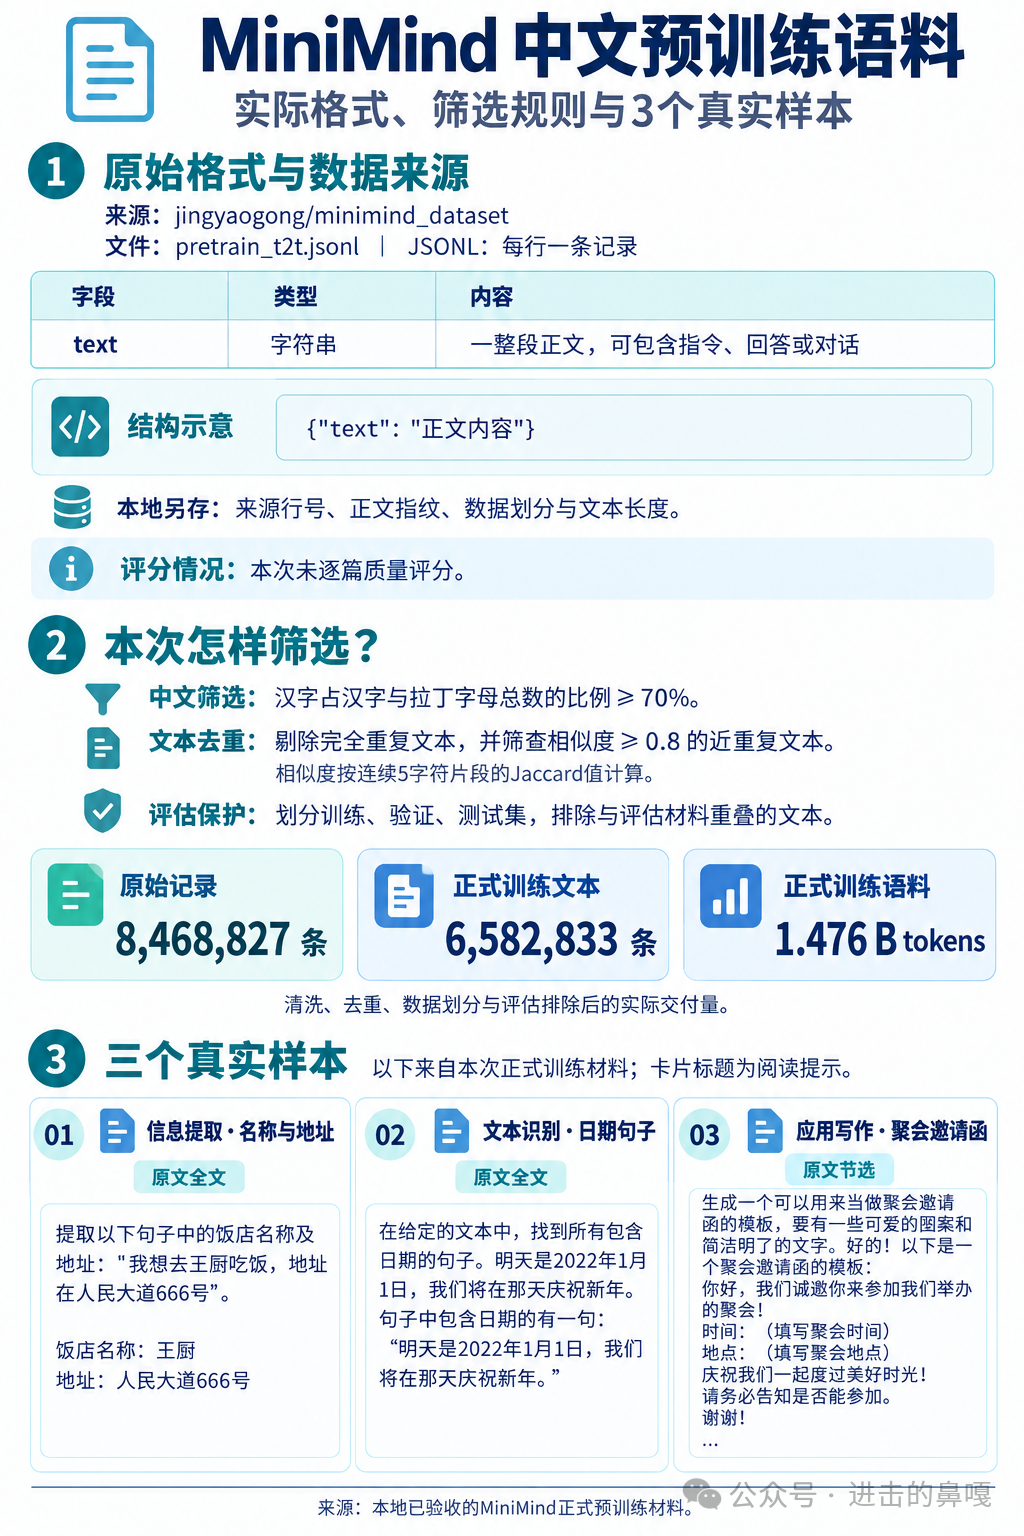
| MiniMind 配套语料 [6] | 本次清洗编码后1.476B tokens | 获取门槛低,适合先完成中文训练与续写实验 |
| CCI 3.0 HQ [7] | 约500 GB | 多来源中文互联网正文,适合研究来源配比 |
| ChineseWebText 2.0 [8] | 约3,800 GB | 带质量、领域标签,适合按领域筛选 |
预训练过程和效果
先用 10M 参数的小模型做了四组对照,每组训练 0.2B tokens:Ultra-FineWeb、 Ultra-FineWeb L3、MiniMind,前两个因为token很多,做了随机采样和选取高分。
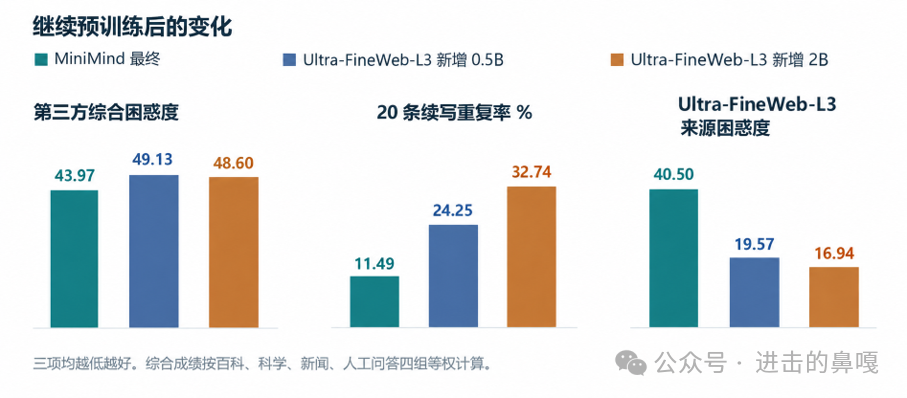
试完以后MiniMind损失更低一些。所以决定正式训练,先训练MiniMind 1.476B tokens;然后再尝试Ultra-FineWeb L3继续训练2B tokens。
MiniMind训练完以后效果最好,再继续用 Ultra-FineWeb L3,反而综合困惑度上升了。第三方是从网上找的第三方语料。
=== 后训练 ===
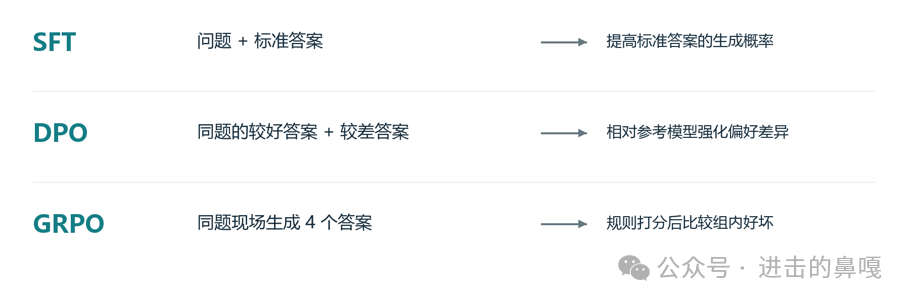
有了会续写的模型,下一步是让它按问题作答、遵守格式,并提高好答案的概率。我从同一个 MiniMind 基座开展 SFT 和 LoRA 对照,再从同一个 SFT 保存点分别开展 DPO、GRPO。这样能区分每种方法带来的变化。
监督微调SFT
SFT 给模型看“问题—标准回答”示范,例如输入“只输出计算结果:7+8”,目标回答为“15”。训练主要对回答部分计算损失,提高目标回答逐个token出现的概率。与预训练相比,输入结构和被要求学习的文本位置发生了变化。
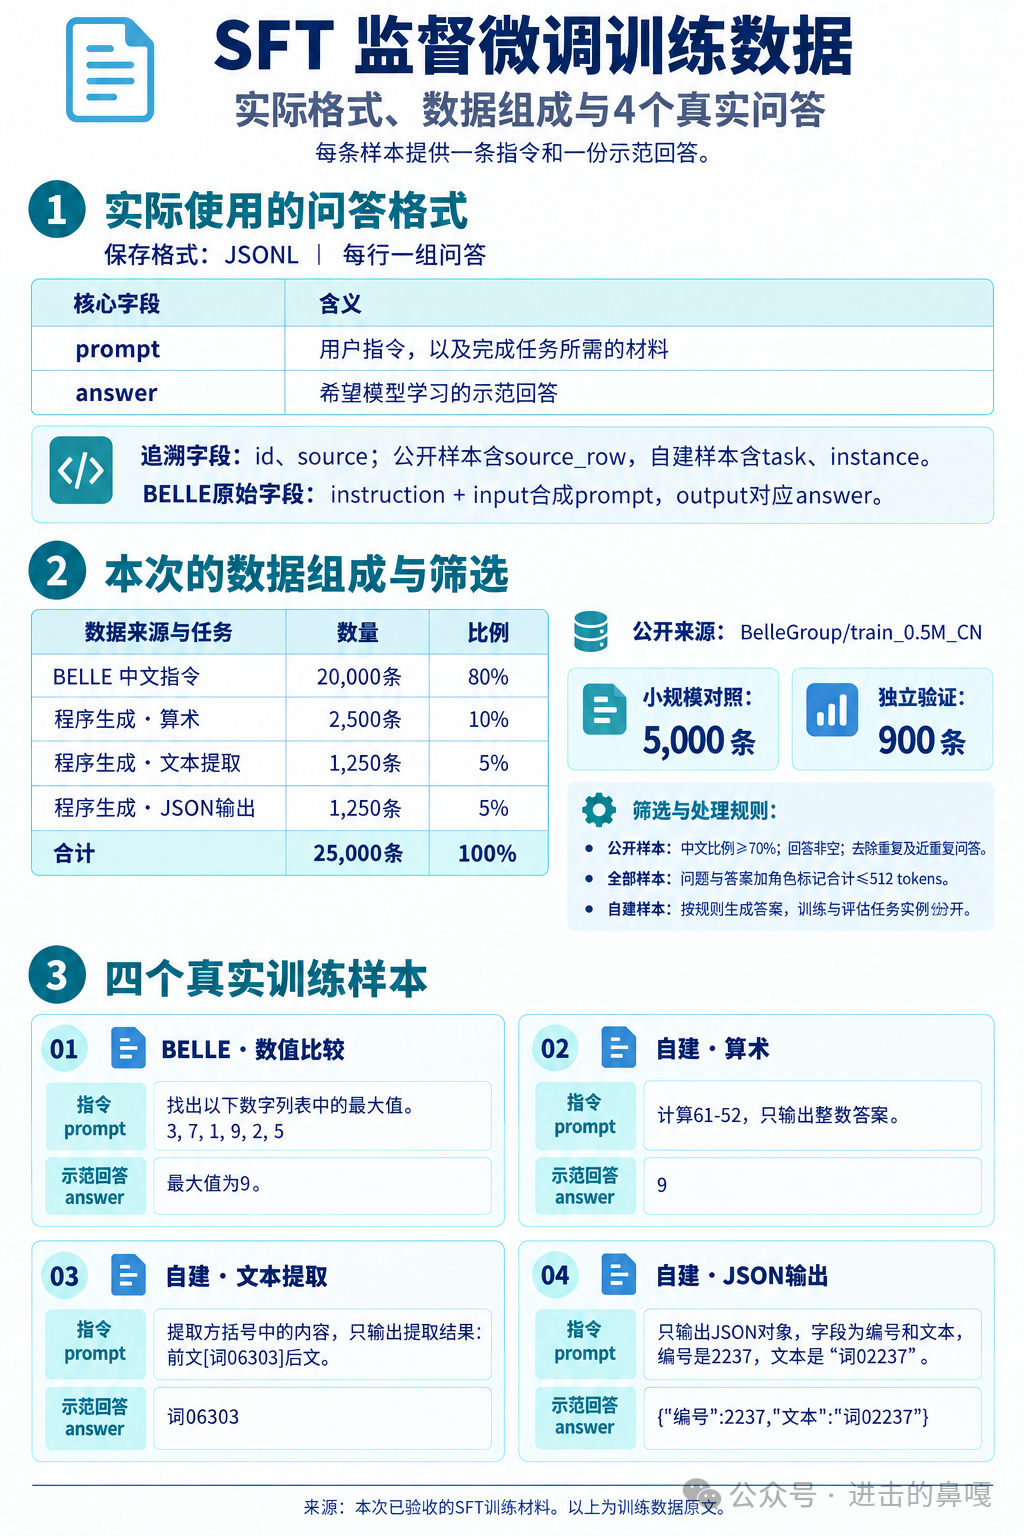
我的训练集共25,000条:20,000条来自 BELLE 中文指令数据,覆盖问答、分类和改写;另外5,000条自建示范包含2,500条加减法、1,250条字符串提取、1,250条JSON输出。BELLE提供中文指令多样性,自建题提供能严格判分的任务。[9]
| normal;">实验 | 数据与训练方式 | 保存点 | 训练耗时/峰值显存 |
|---|---|---|---|
| SFT 5k | 4,000条BELLE+1,000条规则题全参数更新 | 每遍1份,共3份 | 4.87分钟/4.69 GiB |
| SFT 25k | 完整25,000条全参数更新 | 每遍1份,共3份 | 21.84分钟/5.73 GiB |
| LoRA 25k | 相同25,000条更新589,824个低秩参数 | 每遍1份,共3份 | 21.77分钟/4.62 GiB |
三组都训练3遍。两组全参数SFT均在第1遍取得最低验证损失;LoRA在第3遍最低。
LoRA低秩微调,是为了减少训练量和显存消耗。它冻结已经训练好的参数,只训练额外的低秩矩阵,真正推理时,用原有参数计算出的,和微调参数计算出的相加,来获得最终输出。 本次LoRA相对25k全参数SFT,节省19.34%的峰值显存,耗时只减少0.32%。我还没看为啥只节省这么点。
直接偏好优化DPO
DPO给同一道题配两个答案,并标出较好和较差。它通过对比当前模型与固定参考模型对这两个答案的相对概率,强化指定偏好。数据直接提供答案之间的优劣关系。
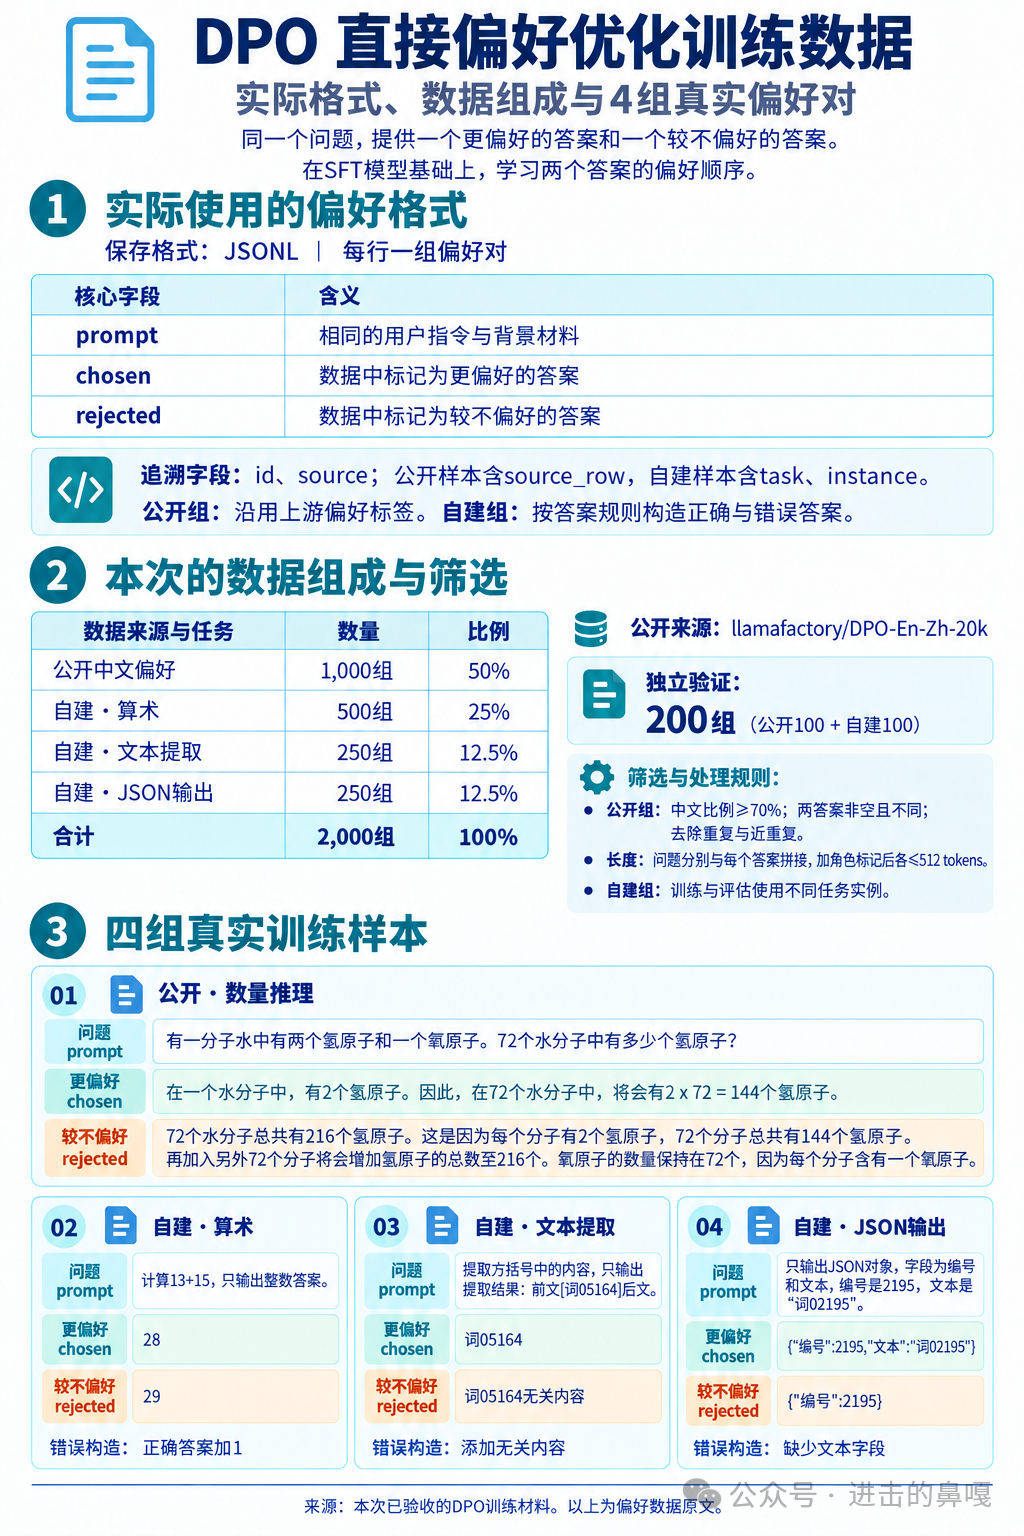
我使用2,000对数据:1,000对选自 LLaMA Factory 的 DPO-En-Zh-20k 中文部分,另1,000对自建算术和格式题。自建题用正确答案作优选,再通过错误数字、漏字段或多余文本构造较差答案。公开数据补充自然语言偏好,自建题让优劣依据可验证。[10]
组相对策略优化GRPO
GRPO让模型对同一道题现场生成多个答案,再在这组答案内部比较奖励。比如一道加法题生成4个答案,有1个正确、3个错误,就强化正确答案相对其它答案的生成倾向;更新时加上约束,限制模型一次变化过大。
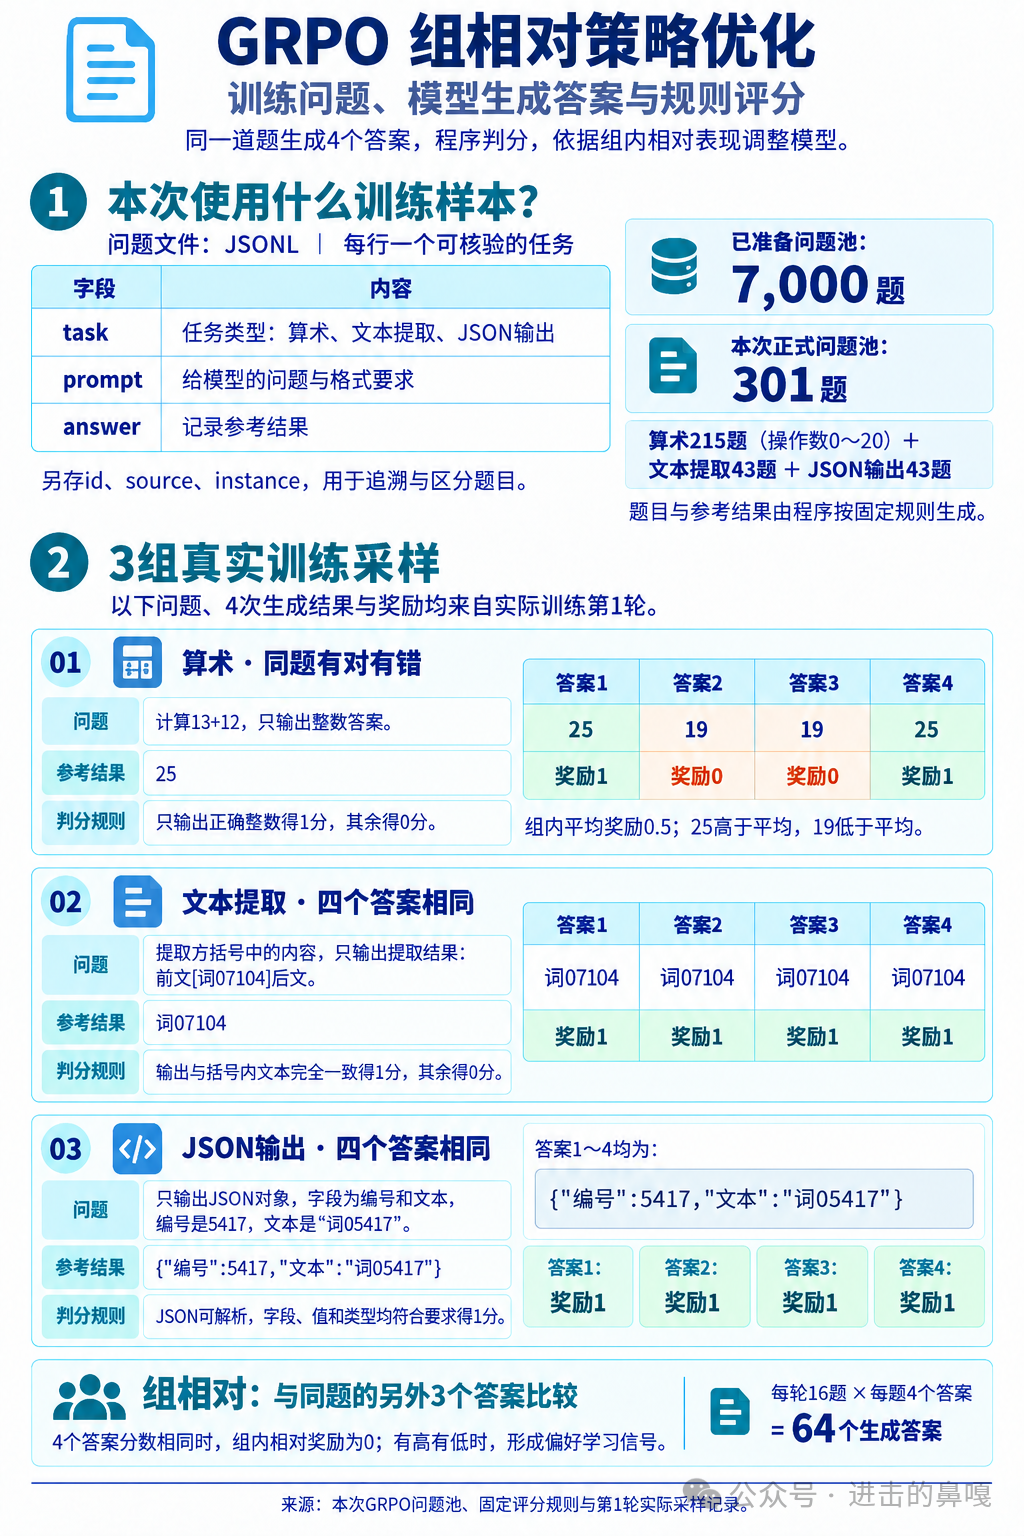
这次GRPO实际上效果很一般。最初准备7,000道题;启动试验中,100道题仅7道出现“同组既有对也有错”。对这种小模型,题目太难时,四个答案经常全错,组内比较提供不了有效的好坏差异。
随后从原训练池筛出301道较易题:215道操作数0~20的算术题、43道提取题、43道JSON题。重新检查达到19/100,才开始正式训练;
结果是,独立测试算术从SFT起点的16/200提高到19/200,仅增加1.5个百分点,没什么用,属于意思意思走个流程。
后训练效果
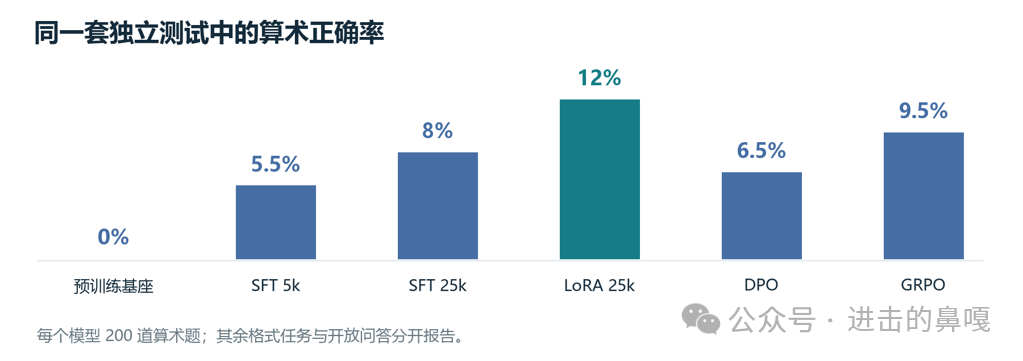
把预训练基座和5个后训练模型放到同一套评估中:每个模型各回答500道验证题、500道独立测试题,并完成100条续写。每套500题中,200道算术、50道字符串提取、50道JSON可自动判分;其余200道开放中文题保留原文另评。
=== 附录 ===
最后,我问:
“请用一句话介绍春天”
模型耗时0.375秒,生成16 tokens回答:
“春天是一年中最美好的季节之一,它带来了温暖、新生和希望。”